
Gemma 4 QAT marca um novo passo da Google na execução local de modelos de inteligência artificial em hardware de consumo. A empresa publicou os novos checkpoints a 5 de Junho de 2026 e afirma que o modelo E2B pode ocupar menos de 1 GB de RAM em modo texto.
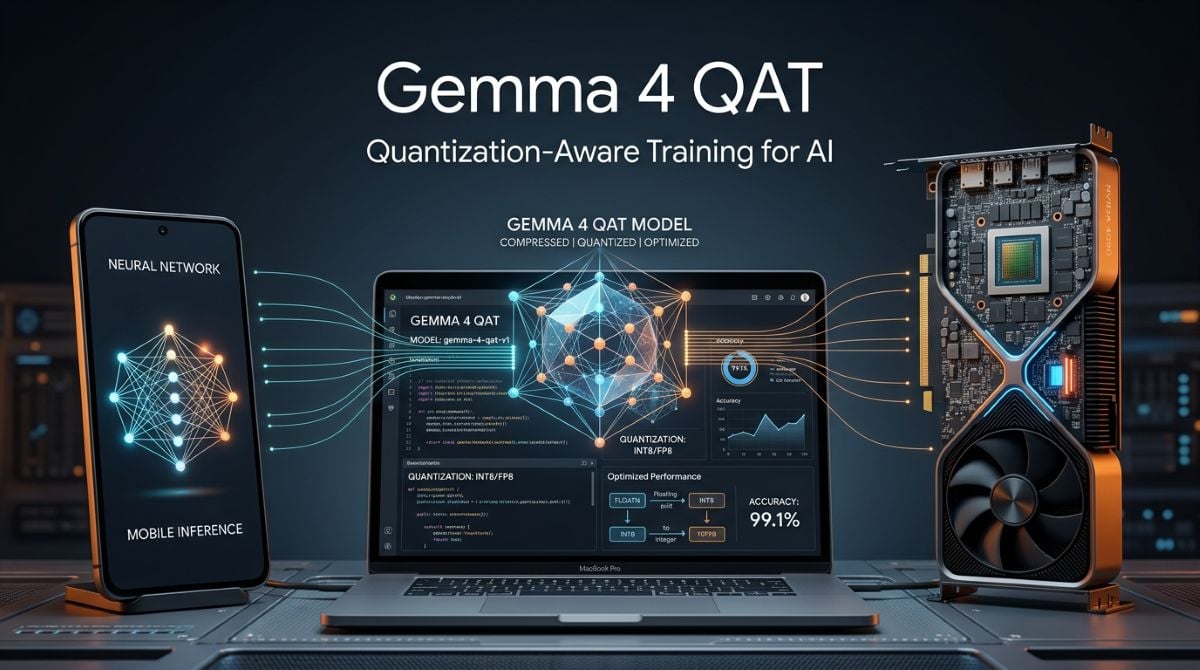
No anúncio oficial da Google sobre o Gemma 4 QAT, a empresa apresenta uma linha de checkpoints optimizados para reduzir requisitos de memória e melhorar o desempenho em dispositivo. O lançamento cobre cinco variantes da família Gemma 4 e inclui formatos adaptados a ecossistemas como GGUF, vLLM e LiteRT-LM.
O contexto técnico
O lançamento do Gemma 4 QAT ganha sentido quando se olha para o Gemma 4 12B, publicado poucos dias antes como um modelo multimodal unificado e sem codificadores separados. A Google posicionou esse modelo como uma base para execução local em máquinas com memória limitada, incluindo portáteis com 16 GB de VRAM ou memória unificada.
O guia técnico para programadores reforça essa leitura ao descrever uma arquitectura que processa texto, imagem, áudio e vídeo com um backbone comum. A decisão reduz complexidade estrutural e favorece cenários de execução local, especialmente quando o objectivo é conter consumo de memória e simplificar a integração.
O que distingue o QAT
O Quantization-Aware Training difere da quantização pós-treino porque integra os efeitos da compressão no próprio processo de treino, em vez de comprimir o modelo apenas no fim. A Google afirma que este método ajuda a preservar qualidade próxima de bfloat16 ao mesmo tempo que reduz de forma acentuada os requisitos de memória.
Na prática, os checkpoints Gemma 4 QAT procuram funcionar como versões oficialmente comprimidas para execução local. Isso reduz a dependência de quantizações comunitárias feitas depois do treino, embora o resultado final continue a depender do hardware, do runtime e da tarefa em execução.
Os modelos e a memória necessária
A Google disponibilizou cinco variantes da família Gemma 4 com perfis diferentes de compressão e memória. Os modelos mais pequenos usam formatos móveis a 2 bits, enquanto os maiores recorrem a Q4_0 para equilibrar tamanho e utilidade prática.
| Modelo | Formato | Memória indicada pela Google | Hardware-alvo |
|---|---|---|---|
| Gemma 4 E2B | móvel 2 bits | menos de 1 GB em modo texto | telemóveis e dispositivos de fronteira |
| Gemma 4 E4B | móvel 2 bits | cerca de 3 GB | portáteis de entrada |
| Gemma 4 12B | Q4_0 | cerca de 7 GB | portáteis com memória unificada ou GPU dedicada |
| Gemma 4 26B A4B | Q4_0 | cerca de 15 GB | portáteis e estações de trabalho |
| Gemma 4 31B | Q4_0 | cerca de 18 GB | desktops com GPU de 24 GB |
A Google apresenta estes valores como estimativas. O consumo real pode variar consoante o sistema operativo, as modalidades activadas e a pilha de execução escolhida.
A arquitectura móvel e os formatos suportados
A estratégia móvel da Google para os modelos E2B e E4B assenta numa quantização pensada para aceleradores locais. A empresa descreve activações estáticas pré-calculadas, quantização por canal, compressão selectiva a 2 bits e optimização da cache KV e dos embeddings como elementos centrais dessa abordagem.
Os checkpoints estão disponíveis em GGUF para ecossistemas como llama.cpp, LM Studio e Ollama, em tensores comprimidos para vLLM, e num formato móvel orientado para LiteRT-LM. Esta diversidade de formatos é relevante porque reduz o trabalho de conversão e aproxima o lançamento das ferramentas já usadas na IA local.
O papel do Gemma 4 12B
O Gemma 4 12B ajuda a explicar por que motivo a Google avançou para versões QAT oficiais logo a seguir. No anúncio do modelo, a empresa descreve-o como o primeiro modelo multimodal de tamanho médio sem codificadores, com desempenho próximo do Gemma 4 26B A4B em vários testes, mas com menos de metade da pegada de memória.
No guia técnico, a Google acrescenta que o modelo suporta entrada nativa de áudio e vídeo e foi pensado para correr localmente em máquinas com 16 GB de VRAM ou memória unificada. Esse enquadramento reforça a ideia de que os checkpoints QAT não surgem isolados, mas como continuação de uma estratégia de expansão da execução local para hardware de consumo.
Implicações para programadores
Para programadores e integradores, o efeito mais imediato é a existência de uma linha oficial de modelos comprimidos, em vez da dependência exclusiva de quantizações comunitárias. Isso tende a melhorar previsibilidade, compatibilidade e documentação, sobretudo em projectos que precisam de suporte directo nos formatos já reconhecidos por ecossistemas como Hugging Face, Ollama ou LM Studio.
No anúncio oficial, Olivier Lacombe, Director of Product Management na Google DeepMind, enquadra estes checkpoints como uma forma de reduzir de forma acentuada os requisitos de memória e melhorar o desempenho em dispositivo. A formulação aponta para um objectivo claro de produto, mas não substitui validação independente em cargas de trabalho reais.
Limitações e prudência editorial
Há dois pontos que exigem cautela. O primeiro é que a alegação de qualidade semelhante a bfloat16 vem da própria Google e não de uma avaliação independente publicada por terceiros com validação ampla.
O segundo é que os valores de memória indicados são aproximados e não equivalem a uma garantia operacional universal. Em tarefas complexas, sobretudo com contexto longo, multimodalidade activa ou runtimes diferentes, o comportamento pode afastar-se do cenário descrito na documentação oficial.
Conclusão
Os modelos Gemma 4 QAT foram publicados no blog oficial da Google a 5 de Junho de 2026 e reforçam uma tendência clara no mercado de IA generativa. O foco já não está apenas na escala do modelo, mas na capacidade de o executar localmente com limites realistas de memória e energia.
Se a promessa da Google se confirmar em testes independentes, estes checkpoints podem tornar-se referência para execução local comprimida em hardware de consumo. Até lá, o lançamento deve ser lido como um avanço técnico relevante, mas ainda sujeito à verificação que separa alegação de desempenho de prova consolidada.
FAQ – Perguntas frequentes
O que é o Gemma 4 QAT?
É a versão dos modelos Gemma 4 optimizada com Quantization-Aware Training, uma técnica que introduz os efeitos da quantização durante o treino para reduzir memória com menor perda de qualidade. A Google publicou estes checkpoints no blog oficial a 5 de Junho de 2026.
O Gemma 4 QAT corre num telemóvel?
Segundo a Google, sim, pelo menos no caso do Gemma 4 E2B em modo texto, com um requisito inferior a 1 GB de RAM. Isso depende do formato móvel específico e do uso de runtimes compatíveis, como o LiteRT-LM.
Porque é que o Gemma 4 12B é relevante para este tema?
Porque o Gemma 4 12B introduziu uma arquitectura multimodal unificada e foi posicionado pela Google para execução local em hardware com 16 GB de memória. Os checkpoints QAT aparecem como extensão lógica dessa estratégia de execução fora da nuvem.
Pontos principais
- Os modelos Gemma 4 QAT foram publicados no blog oficial da Google a 5 de Junho de 2026.
- A Google afirma que o Gemma 4 E2B pode correr em menos de 1 GB de RAM em modo texto.
- O Gemma 4 12B introduziu uma arquitectura multimodal sem codificadores separados.
- Os novos checkpoints suportam formatos como GGUF, tensores comprimidos e LiteRT-LM.
- As alegações de qualidade e eficiência ainda precisam de validação independente em testes externos.
Outros artigos interessantes: