
Quando uma empresa decide adaptar um modelo de inteligência artificial às suas necessidades, depara-se com duas opções técnicas, a destilação de LLM e o fine-tuning (ajuste fino), mais conhecido pelo termo inglês fine-tuning. As duas técnicas são frequentemente apresentadas como alternativas, mas têm objetivos distintos, custos muito diferentes e casos de uso que raramente se sobrepõem. Perceber a diferença entre elas permite evitar desperdício de recursos e garantir o desempenho esperado em produção. Para quem ainda não está familiarizado com o conceito de destilação, recomendamos a leitura do artigo Destilação de modelos de IA: o que é e como funciona.
O que separa as duas técnicas
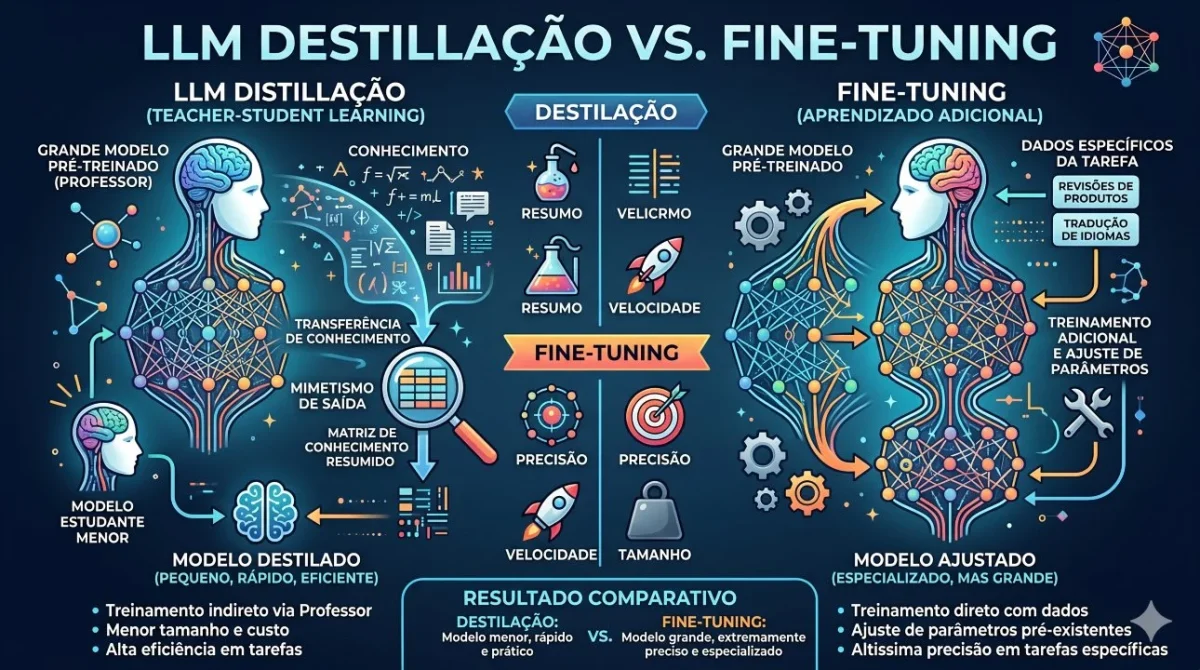
A destilação de LLM e o ajuste fino de modelos de linguagem partem de premissas completamente diferentes. A destilação começa com dois modelos, um professor, grande e poderoso, e um aluno, mais pequeno, que aprende a replicar o comportamento do professor. O objetivo é a compressão com preservação de capacidades. O fine-tuning parte de um único modelo pré-treinado e ajusta os seus pesos com novos dados específicos de um domínio. O objetivo é a especialização, não a compressão.
As duas técnicas respondem, portanto, a perguntas diferentes. A destilação responde a “como posso ter um modelo mais pequeno e barato que se comporte como este modelo grande?”. O fine-tuning responde a “como posso fazer com que este modelo saiba mais sobre o meu domínio específico?”.
Como funciona o ajuste fino de modelos de linguagem
O fine-tuning consiste em continuar o treino de um modelo pré-treinado com um conjunto de dados específico e rotulado. O modelo já aprendeu a linguagem e o raciocínio geral durante o pré-treino; o ajuste fino calibra esses conhecimentos para uma tarefa ou domínio concreto, segundo a Google. Um modelo de linguagem geral pode, por exemplo, ser submetido a fine-tuning com milhares de documentos jurídicos e passar a redigir contratos com a terminologia e a estrutura corretas.
O processo exige dados de alta qualidade e rotulados, o que representa o principal custo e obstáculo desta abordagem. Segundo a Microsoft Azure, o fine-tuning é recomendado apenas quando a engenharia de contexto (prompt engineering) e a recuperação aumentada de informação (RAG) já foram tentadas e se revelaram insuficientes para a tarefa em causa. O ajuste fino altera permanentemente os pesos do modelo, o que implica que qualquer atualização do modelo base exige uma nova iteração do processo.
Como funciona a destilação de LLM
A destilação de LLM, como explorámos no artigo pilar desta série, transfere o conhecimento de um modelo professor para um modelo aluno mais pequeno, com recurso às distribuições de probabilidade geradas pelo professor. O modelo aluno não aprende apenas respostas corretas. Aprende os padrões de raciocínio do professor, o que a IBM descreve como “rótulos suaves” (soft labels).
O custo da destilação é estruturalmente diferente do fine-tuning. Não exige dados rotulados por humanos: os dados de treino são gerados pelo próprio modelo professor, segundo a Distill Labs. Exige, no entanto, acesso a esse modelo professor durante o processo, o que pode representar um custo significativo se o professor for um modelo proprietário de terceiros. O resultado final é um modelo mais pequeno, mais rápido e mais barato de operar, mas com capacidades gerais inferiores às do professor.
Destilação vs fine-tuning
| Critério | Destilação de LLM | Fine-tuning |
|---|---|---|
| Objetivo principal | Compressão com preservação de capacidades | Especialização num domínio |
| Ponto de partida | Dois modelos (professor + aluno) | Um modelo pré-treinado |
| Dados necessários | Gerados pelo modelo professor | Rotulados por humanos |
| Resultado | Modelo mais pequeno e eficiente | Modelo especializado |
| Custo de inferência | Reduzido (modelo menor) | Igual ao modelo base |
| Custo de treino | Médio | Médio a elevado |
| Atualização futura | Requer nova destilação | Requer novo fine-tuning |
| Caso de uso típico | Produção em larga escala, edge computing | Domínios especializados com dados proprietários |
Quando usar cada técnica
A escolha entre destilação de LLM e fine-tuning depende fundamentalmente do problema que se quer resolver, segundo a Intuition Labs e a Distill Labs:
Usa destilação quando:
- O principal constrangimento é o custo de inferência ou a velocidade de resposta
- O modelo precisa de correr em hardware limitado, como dispositivos móveis ou sistemas embebidos
- Já existe um modelo professor com as capacidades necessárias
- O objetivo é replicar comportamento geral, não especializar em domínio específico
Usa fine-tuning quando:
- O modelo precisa de dominar terminologia, estilo ou conhecimento proprietário que não existe no pré-treino
- A precisão em tarefas muito específicas é prioritária sobre o custo de inferência
- Existem dados rotulados de alta qualidade disponíveis
- A engenharia de contexto e o RAG já foram tentados sem sucesso
A combinação que as melhores equipas já usam
Na prática, as melhores equipas de IA não escolhem entre as duas técnicas. Combinam-nas sequencialmente: o processo típico começa com o pré-treino de um modelo grande, seguido de fine-tuning com dados de domínio específico, e termina com a destilação desse modelo especializado para um modelo aluno mais pequeno e eficiente para produção, segundo a Agami AI. Este fluxo é já utilizado pela OpenAI, pela Google e pela Meta nos seus modelos de produção.
O DeepSeek seguiu uma variante deste processo no desenvolvimento do V4-Pro, com fine-tuning extensivo de dados de raciocínio seguido de destilação para variantes mais pequenas, num processo que gerou a controvérsia geopolítica que analisámos no artigo EUA alertam aliados para destilação de modelos de IA pela China. A fronteira entre a técnica legítima e a prática contestada não está nas ferramentas em si, mas nos dados usados para as alimentar.
Conclusão
A destilação de LLM e o fine-tuning são abordagens diferentes, mas frequentemente complementares. A primeira procura reduzir o tamanho e o custo de um modelo, enquanto a segunda o adapta a uma tarefa ou domínio específico.
Na prática, a escolha depende do objetivo final. Se a prioridade for eficiência e rapidez, a destilação tende a ser a opção mais interessante. Se a prioridade for especialização e precisão em contexto, o fine-tuning continua a ser a via mais direta.
Em muitos projetos, a melhor estratégia pode passa por combinar as duas técnicas. Essa combinação poderá permite encontrar um equilíbrio mais sólido entre desempenho, custo e aplicabilidade real.
FAQ
A destilação de LLM e o fine-tuning podem ser usados em simultâneo?
Sim. O fluxo mais eficiente consiste em aplicar fine-tuning a um modelo base com dados de domínio específico e, de seguida, destilar esse modelo especializado para um modelo aluno mais pequeno. O resultado é um modelo eficiente e especializado, segundo a Agami AI.
Qual das duas técnicas é mais cara?
Depende do contexto. O fine-tuning exige dados rotulados por humanos, que têm um custo elevado de produção. A destilação exige acesso ao modelo professor durante o treino, o que pode ser custoso se for um modelo proprietário de terceiros. Em termos de custo de inferência em produção, o modelo destilado é sistematicamente mais barato, segundo a Distill Labs.
É possível aplicar fine-tuning a um modelo já destilado?
Sim. Um modelo aluno destilado pode ser submetido a fine-tuning posterior para especialização adicional. Esta abordagem combina a eficiência da destilação com a precisão do ajuste fino e é já prática corrente em projetos de produção de escala industrial.
Fontes
- Google: LLMs: ajuste fino, destilação e engenharia de comando
- Microsoft Azure: Considerações de ajuste fino dos modelos do Azure OpenAI
- Distill Labs: Distillation vs Fine-Tuning: What’s the Difference?
- Intuition Labs: Fine-Tuning vs Distillation vs Prompt Engineering for LLMs
- Agami AI: Context Engineering vs Fine-Tuning vs Distillation: How to Decide