
Os limites da destilação de LLM em contexto real são menos discutidos do que as suas vantagens, mas são igualmente determinantes para qualquer organização que pondere adotar esta técnica. Nos artigos anteriores desta série, analisámos o que é a destilação, como se compara ao fine-tuning e de que forma amplia o acesso à IA. Neste artigo, o foco é inverso: o que é que a destilação ainda não consegue fazer, e quando é que outras abordagens são mais adequadas.
A resposta não é linear, mas os dados disponíveis permitem identificar padrões consistentes.
Raciocínio complexo: onde os modelos pequenos falham
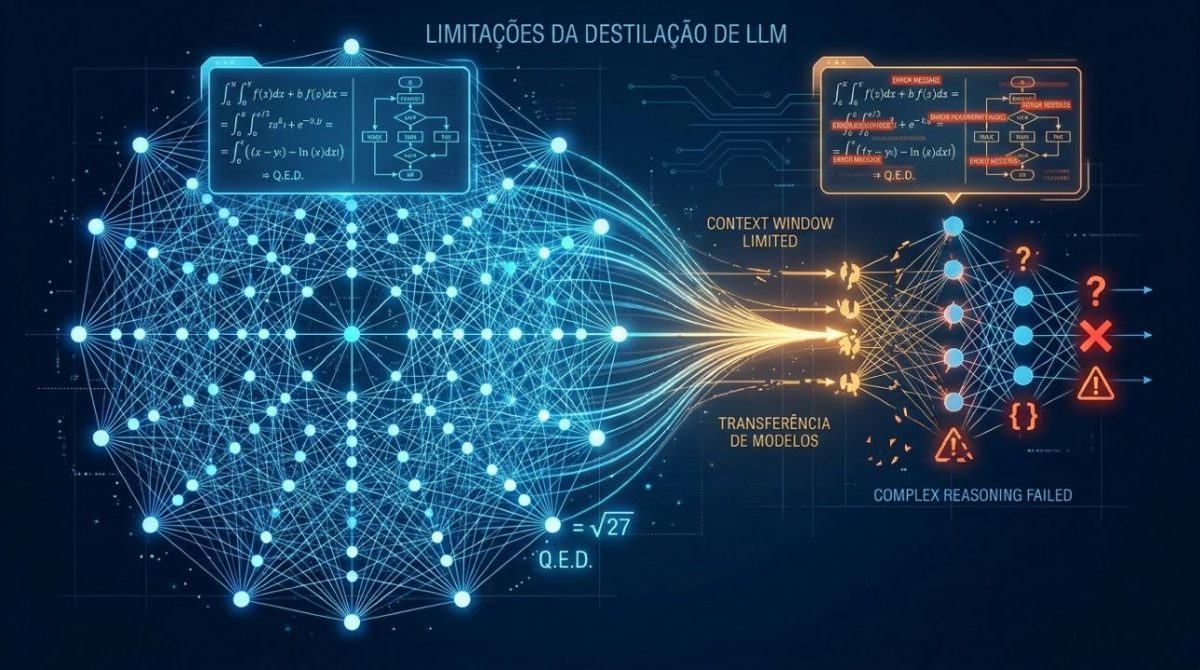
O desempenho de 95% a 97% frequentemente citado para modelos destilados aplica-se a tarefas gerais de linguagem natural. Em tarefas que exigem raciocínio multi-passo, matemática avançada, programação complexa ou análise lógica profunda, a degradação de desempenho é mais acentuada e pode comprometer a utilidade do modelo em produção.
Benchmarks como o MATH, o HumanEval e o GSM8K mostram consistentemente que modelos de menor dimensão, mesmo quando destilados a partir de modelos de topo, registam quedas de desempenho significativas nestas categorias. Para aplicações que dependem de precisão lógica elevada, esta limitação não é desprezável.
Janela de contexto e memória limitadas
Modelos destilados tendem a ter janelas de contexto mais reduzidas do que os modelos originais. Esta limitação afeta diretamente tarefas que envolvem processamento de documentos longos, análise de contratos, conversas extensas ou síntese de grandes volumes de texto.
Num ambiente empresarial, onde os casos de uso frequentemente envolvem documentação técnica extensa ou histórico de interações prolongado, esta restrição pode inviabilizar a adoção de modelos destilados sem adaptações adicionais, o que reduz, na prática, parte das vantagens de custo associadas à técnica.
Erros e enviesamentos herdados do modelo professor
A destilação transfere conhecimento, mas também transfere falhas. Os enviesamentos, erros factuais e limitações éticas do modelo professor são comprimidos juntamente com as suas capacidades e chegam ao modelo aluno sem filtragem adicional.
Este aspeto tem consequências diretas para organizações que operam em setores regulados ou que lidam com públicos sensíveis. Um modelo destilado a partir de um modelo professor com enviesamentos de género, culturais ou linguísticos reproduzirá esses problemas, por vezes de forma amplificada, uma vez que a compressão pode reduzir a capacidade do modelo de lidar com casos fora da distribuição esperada.
Domínios especializados: quando a destilação não chega
Em áreas como medicina, direito, engenharia de precisão ou cibersegurança avançada, a precisão exigida raramente é compatível com as perdas de desempenho introduzidas pela destilação. Nestes contextos, o fine-tuning com dados especializados e verificados tende a ser a abordagem mais adequada, porque permite controlar diretamente o domínio de conhecimento do modelo.
A destilação pode funcionar como base inicial, mas não substitui a especialização rigorosa que estas áreas exigem. A combinação das duas técnicas – destilação seguida de fine-tuning – é muitas vezes a solução mais equilibrada, mas também a mais exigente em termos de recursos e validação.
Os custos que a destilação não elimina
A redução dos custos de treino é real, mas não elimina os custos de validação, avaliação de segurança e monitorização contínua. Em contextos regulados, como o setor financeiro ou a saúde, estes custos podem ser tão ou mais significativos do que os custos de treino.
Acresce que a manutenção de um modelo destilado exige atualizações periódicas para acompanhar a evolução do modelo professor, o que implica ciclos de redestilação com os respetivos custos associados. Para organizações sem equipas técnicas dedicadas, este custo operacional adicional pode ser um obstáculo concreto.
Quando usar e quando evitar a destilação
A destilação é adequada quando o objetivo é reduzir custos de inferência em tarefas gerais de linguagem natural, implementar modelos em dispositivos com recursos limitados ou ampliar o acesso a capacidades de IA sem infraestrutura de grande escala. É uma escolha adequada para chatbots, sistemas de recomendação, classificação de texto e assistentes de uso geral.
A destilação deve ser evitada, ou complementada com outras técnicas, quando a aplicação exige raciocínio lógico de alta precisão, processamento de contextos muito longos, especialização em domínios regulados ou garantias éticas e de segurança rigorosas. Em contexto real, o fine-tuning, a combinação de ambas as técnicas, ou mesmo a utilização direta do modelo professor, tendem a ser as opções mais adequadas.
Outros artigos interessantes:
- Fitbit lança coach de saúde com IA com sete novas funções
- ChatGPT Images 2.0 pensa e investiga antes de criar
- O que é o DSA e o que muda para os utilizadores europeus
FAQ
Os modelos destilados são sempre menos precisos do que os modelos originais?
Não necessariamente em todas as tarefas. Em linguagem natural geral, a diferença é mínima. Em raciocínio complexo, matemática ou domínios muito especializados, a degradação pode ser significativa.
A destilação pode corrigir os enviesamentos do modelo professor?
Não. A destilação transfere o conhecimento do modelo professor, incluindo as suas falhas. A correção de enviesamentos exige intervenção explícita antes ou depois do processo de destilação.
Existe uma regra para decidir entre destilação e fine-tuning?
Não existe uma regra universal. A escolha depende do objetivo, do domínio de aplicação, dos recursos disponíveis e do nível de precisão exigido. Em muitos projetos, as duas técnicas são usadas em conjunto.
Os modelos destilados são seguros para uso em setores regulados?
Dependem de validação rigorosa. A redução de custos de treino não dispensa os processos de auditoria, teste e certificação exigidos em setores como a saúde, o direito ou as finanças.
Fontes
- Hugging Face / arXiv – DistilBERT paper original
- Zylos Research – Model Distillation and Knowledge Transfer in AI 2026
- Galileo AI – How Much Does LLM Training Cost?
- Darrow AI – The Era of Distilled LLMs: Why Smaller Can Be Better
- Redis – Model Distillation for LLMs: Cut Costs & Boost Speed in 2026
- HTEC – AI Model Distillation Evolution and Strategic Imperatives in 2025